Perceptio:让视觉语言模型先“画出空间”,再回答
关于我们 2026 年预印本的一篇短研究笔记:把分割与深度 token 作为显式的空间思维链
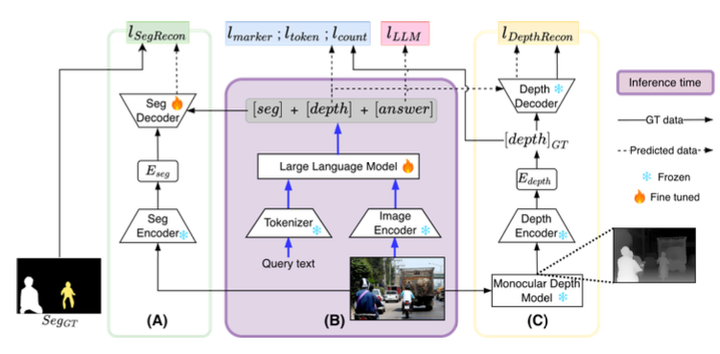 Perceptio 在自回归序列中先输出空间 token(先分割、后深度),再给出答案。
论文: arXiv 2603.18795 · Hugging Face · 知乎长文
问题
大视觉语言模型很擅长回答图里“有什么”,却常常说不清“在哪里”。问它两个物体哪个离相机更近,或者让它分割“左数第二个杯子”,模型只能在内部隐式地推断几何关系,从不写出一个可供检查的空间解释。
思路:先感知,再回答
Perceptio 把感知过程放进 token 序列。在作答之前,模型会在同一条自回归序列里先生成两类空间 token:
- 分割 token:基于 SAM2,用来定位被提及的物体;
- 深度 token:来自一个从强单目深度教师模型蒸馏得到的 VQ-VAE 码本,把稠密深度图压缩成一段简短的离散序列。
随后,答案以模型自己画出的这张“空间草图”为条件。可以把它理解为一条由掩码和深度码、而不是文字组成的思维链;而且这些 token 能解码回掩码和深度图,所以这条思维链是可以被直接查看的。
让深度 token 可训练
只用普通的下一个 token 损失来生成大段深度码并不稳定。两点改进起了作用:
- 组合式深度 token 目标:marker、token 与 count 三种损失联合使用;
- 软合并(soft merging):让由预测 token 重建深度的过程可微,从而模型也会在它“隐含”的深度图上得到监督。
模型以 InternVL 为基座,在多任务数据上联合训练,同一套感知 token 同时服务于分割、空间问答与通用 VQA。
结果
与论文中报告的最强基线相比:
| 基准 | 提升 |
|---|---|
| 指代分割 RefCOCO / RefCOCO+ / RefCOCOg(cIoU) | +0.8 / +1.4 / +1.1 |
| HardBLINK 空间理解(准确率) | +10.3% |
| MMBench(准确率) | +1.0% |
我最看重的是 HardBLINK 上的提升:在这个基准上,“看得更仔细”没有用,显式的几何信息才有用。
下一步
我认为显式、可检查的中间感知,是多模态模型空间推理乃至世界模型的一个好方向,这也是我博士毕业后想继续深入的方向。
本工作完成于我在 Amazon(Prime Video)实习期间,合作者为 Amanmeet Garg、Shalini Chaudhuri、Rui Zhao 与 Garin Kessler,在此致谢。