01
空间多模态视觉语言模型
开发感知增强的视觉语言模型,通过生成空间 token 理解复杂的二维与三维空间。
Perceptio
Amazon Science
空间推理
二维与三维理解
让模型看懂三维世界,也让它动起来。
我目前是 MBZUAI Metaverse Lab 的博士生,即将进入毕业阶段,师从 Hao Li,研究以空间理解为基础的多模态智能。我致力于构建能够理解与生成二维、三维、视频及四维内容的视觉语言模型与生成模型。代表作包括 Perceptio、UCanDance、PointNeXt 和 3D-CoMPaT。
引用数据截至 2026-10-24
Work Hard, Play Hard, El Psy Congroo!

计算机科学与技术学士
南方科技大学 , 2017 - 2021
计算机学院交换生
新加坡国立大学 , 2020
开发感知增强的视觉语言模型,通过生成空间 token 理解复杂的二维与三维空间。
研究以音乐与动作结构为条件的长时序姿态扩散,实现可控视频生成。
构建可扩展的点云网络与训练策略,实现稳健的三维物体理解和识别。
构建组合式三维数据集与资产,支持材质、部件和物体层面的内容生成与识别。
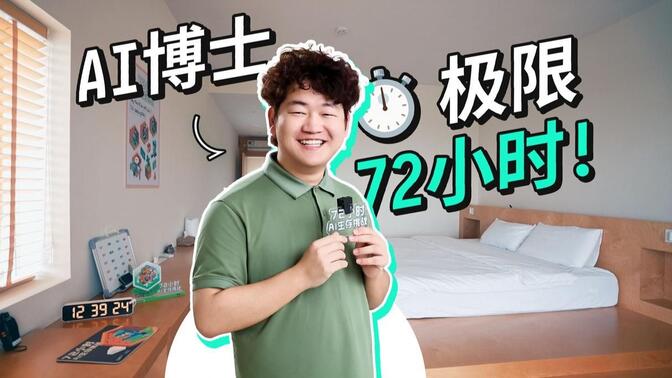
也许你在小红书上认识我——「迪拜王子」。在中东求学和工作多年,参加过 72 小时 AI 生存挑战,讲过脱口秀,也正在请一百位陌生人喝咖啡。
88 条,来自 31 个来源与平台(中文 + English),2016–2026,每条附有指向本人的原文依据。
参与 36氪关于 72 小时 AI 生存挑战的纪实报道,探讨 AI 智能体、AI 视频创作与人机交互。
受嘉程资本邀请,分享对中东 2030 愿景及中国创业者在当地发展机遇的看法。
做客《掘金中东》,分享 KAUST、MBZUAI、Dubai Business Associates、中东高校与当地生活经历。
精选论文与预印本;* 表示同等贡献。完整列表见 Google Scholar。
通过空间 token 生成实现二维与三维空间推理的感知增强视觉语言模型。
重新审视 PointNet++,通过改进训练与扩展策略提升点云理解能力。
用于组合式识别的增强版大规模三维视觉数据集。



更新于:2026 年 10 月
 小红书 · 迪拜王子